Maşın öyrənməsi nədir? (Machine Learning)
Maşın öyrənməsi (Machine Learning, ML) kompüterlərin hər addım üçün ayrıca proqramlaşdırılmadan, məlumatlardan (data) qanunauyğunluqları öyrənməsinə və yeni məlumatlar üzrə proqnoz verməsinə imkan verən süni intellekt sahəsidir. Sadə desək, biz maşına qaydaları yazmırıq, nümunələr veririk, qaydaları isə o özü tapır.
Məsələn, spam filtri üçün “bu söz varsa spam-dır” kimi yüzlərlə qayda yazmaq əvəzinə modelin önünə minlərlə spam və normal məktub qoyulur. Model bu nümunələrdən fərqləndirici əlamətləri özü çıxarır və yeni gələn məktubu təsnif edir.
Maşın öyrənməsinin tərifi və qısa tarixi
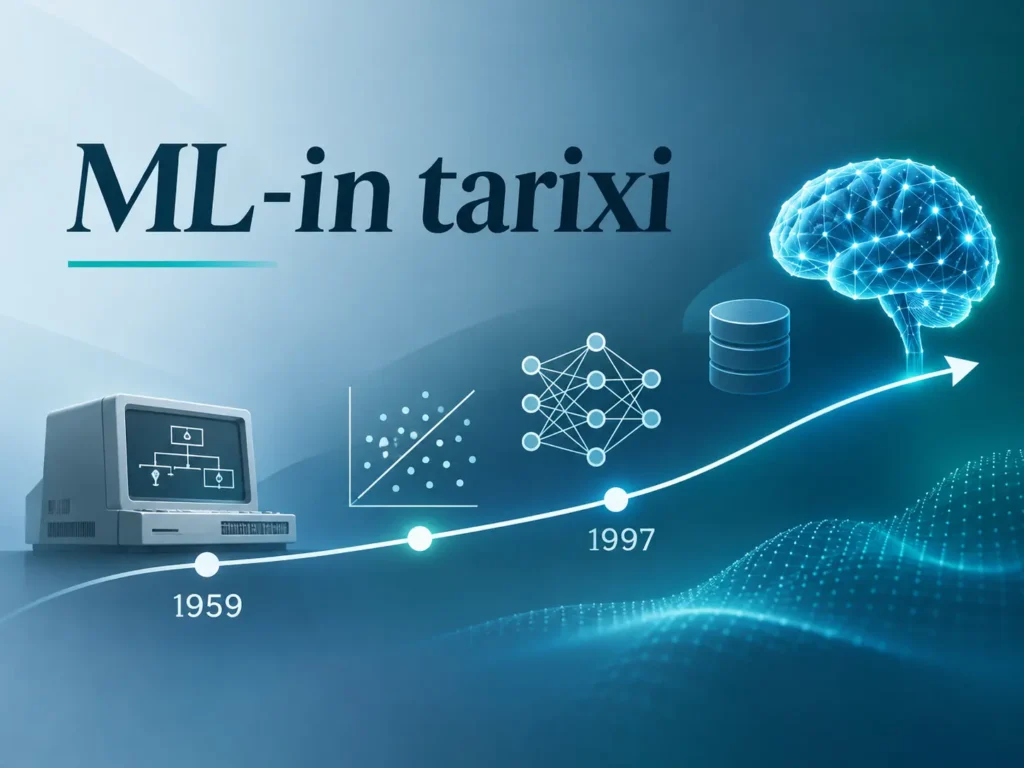
“Machine learning” termini 1959-cu ildə IBM tədqiqatçısı Arthur Samuel tərəfindən işlədilib. Samuel maşın öyrənməsini kompüterlərə açıq şəkildə proqramlaşdırılmadan öyrənmək bacarığı verən sahə kimi təsvir edib. Onun yazdığı şaşka proqramı minlərlə oyun oynayaraq yaxşı və pis gedişləri öyrənmiş və nəticədə müəllifin özündən daha yaxşı oynamağa başlamışdı.
1997-ci ildə Tom M. Mitchell daha formal tərif verib. Ona görə, proqram müəyyən tapşırıqlar (Task, T) üzrə göstəricisi (Performance, P) təcrübə (Experience, E) artdıqca yaxşılaşırsa, həmin proqram öyrənir. Spam nümunəsində T məktubu təsnif etmək, E etiketlənmiş məktublar, P isə düzgün təsnif edilən məktubların faizidir.
Əsas mərhələlər:
| İl | Hadisə |
|---|---|
| 1949 | Donald Hebb neyronların öyrənməsi haqqında nəzəriyyəsini dərc edir |
| 1959 | Arthur Samuel “machine learning” terminini işlədir |
| 1997 | Tom Mitchell formal tərifi verir |
| 2012 | AlexNet şəkil tanımada deep learning dövrünü başladır |
| 2017 | Transformer arxitekturası təqdim olunur; ChatGPT, Claude kimi modellər bunun üzərində qurulub |
Bazar təhlilçiləri ML-in sürətlə böyüdüyünü göstərir. Fortune Business Insights-a görə, qlobal machine learning bazarı 2025-ci ildə 47.99 milyard dollar olub, 2026-cı ildə 65.28 milyard dollara çatacaq və 2034-cü ilə qədər illər üzrə orta hesabla 26.7% (CAGR) böyüyəcək (mənbə).
Süni intellekt, maşın öyrənməsi və deep learning fərqi nələrdir?
Bu üç anlayış tez-tez qarışdırılır, amma onlar bir-birinin içində yerləşən dairələr kimidir: Artificial Intelligence (AI) ən geniş sahədir, Machine Learning onun bir hissəsidir, Deep Learning isə maşın öyrənməsinin bir alt sahəsidir.
| Anlayış | Nədir | Nümunə |
|---|---|---|
| Süni intellekt (AI) | İnsan zəkası tələb edən işləri görən sistemlərin ümumi adı; qaydalara əsaslanan sistemlər də bura daxildir | Şahmat mühərriki, virtual assistent |
| Maşın öyrənməsi (ML) | Qaydaları data-dan öyrənən AI üsulları | Spam filtri, kredit riskinin qiymətləndirilməsi |
| Dərin öyrənmə (Deep Learning) | Çoxqatlı neural network-lər əsasında ML; şəkil, səs və mətn kimi struktursız data ilə işləyir | Üz tanıma, ChatGPT, Claude |
| Generative AI | Deep learning əsasında yeni mətn, şəkil, səs yaradan modellər | Mətn yazan chatbot-lar, şəkil generatorları |
Əsas fərq budur: klassik ML-də modelin istifadə etdiyi əlamətləri (features) çox vaxt insan hazırlayır. Deep learning-də isə neyron şəbəkə bu əlamətləri xam data-dan özü çıxarır, amma bunun üçün daha çox data və hesablama gücü (GPU) lazımdır. Neyron şəbəkələr haqqında ətraflı Neyron şəbəkələri nədir məqaləmizdə oxuya bilərsiniz.
Maşın öyrənməsi necə işləyir?
Maşın öyrənməsi modeli bir dəfəlik qurulmur: data hazırlanır, model öyrədilir, yoxlanılır və nəticə qənaətbəxş olana qədər bu dövrə təkrarlanır.
Əsas terminlər
| Termin | Mənası |
|---|---|
| Dataset | Modelin öyrəndiyi nümunələr toplusu |
| Feature | Modelin girişinə verilən dəyişən, məsələn mənzilin sahəsi |
| Label / Target | Proqnozlaşdırılan cavab, məsələn mənzilin qiyməti |
| Model | Data-dan öyrənilmiş riyazi funksiya |
| Parameter | Modelin öyrənmə zamanı özü tapdığı dəyərlər (çəkilər) |
| Hyperparameter | Öyrənmədən əvvəl insanın seçdiyi ayarlar, məsələn learning rate |
| Loss function | Proqnozun real cavabdan nə qədər uzaq olduğunu ölçür |
| Training | Loss-u azaltmaq üçün parametrlərin tənzimlənməsi |
| Inference | Hazır modelin yeni data üçün proqnoz verməsi |
Addım-addım machine learning prosesi
- Problemin təyini və data toplama. Hansı suala cavab axtarıldığı dəqiqləşdirilir, məsələn “müştəri krediti vaxtında qaytaracaqmı?”. Sonra lazım olan data bazalardan, fayllardan və ya API-lərdən toplanır.
- Data hazırlığı (data preprocessing). Boş dəyərlər və təkrarlar təmizlənir, kateqoriyalar rəqəmə çevrilir (encoding), dəyərlər eyni miqyasa gətirilir (scaling). Feature engineering mərhələsində mövcud sütunlardan yeni, daha mənalı əlamətlər yaradılır.
- Data-nın bölünməsi. Data training, validation və test hissələrinə ayrılır, məsələn 70/15/15. Test hissəsi modelin əvvəl görmədiyi data üzərində yoxlanması üçündür.
- Model training. Alqoritm loss function-ı minimuma endirmək üçün parametrlərini addım-addım dəyişir; əksər modellərdə bu Gradient Descent üsulu ilə edilir. Hyperparameter tuning mərhələsində ən yaxşı ayarlar validation data-sında seçilir.
- Evaluation. Model test data-sında Accuracy, F1-score, RMSE kimi metriklərlə qiymətləndirilir. Nəticə zəifdirsə, data hazırlığına və ya model seçiminə qayıdılır.
- Deployment və inference. Hazır model veb sayta, mobil tətbiqə və ya daxili sistemə API kimi qoşulur və real vaxtda proqnoz verir.
- Monitoring. Zaman keçdikcə real data dəyişir (data drift) və modelin dəqiqliyi düşür. Ona görə model izlənilir və yeni data ilə yenidən öyrədilir (retraining).
Maşın öyrənməsinin növləri
Maşın öyrənməsi data-nın etiketli olub-olmamasına və modelin necə öyrəndiyinə görə dörd əsas növə bölünür.
| Növ | Data | Məqsəd | Nümunə |
|---|---|---|---|
| Supervised learning | Etiketli (labeled) | Doğru cavabı proqnozlaşdırmaq | Mənzil qiyməti, spam filtri |
| Unsupervised learning | Etiketsiz (unlabeled) | Gizli struktur və qruplar tapmaq | Müştəri seqmentasiyası |
| Semi-supervised learning | Az etiketli + çox etiketsiz | Az etiketlə yüksək dəqiqlik | Tibbi şəkillərin təsnifatı |
| Reinforcement learning | Mükafat və cəza siqnalları | Ən yaxşı strategiyanı öyrənmək | Oyun oynayan agentlər, robotlar |
Supervised learning (nəzarətli öyrənmə) nədir?
Supervised learning-də model hər nümunənin doğru cavabı (label) olan data üzərində öyrədilir. Model giriş (input) ilə çıxış (output) arasındakı əlaqəni öyrənir və sonra yeni nümunə üçün cavabı proqnozlaşdırır. İki əsas tapşırıq növü var:
- Classification (təsnifat): cavab kateqoriyadır. Məsələn, məktub spam-dır ya yox, müştəri krediti qaytaracaq ya yox.
- Regression (reqressiya): cavab ədəddir. Məsələn, Bakıda 3 otaqlı mənzilin qiyməti və ya gələn ayın satış həcmi.
Unsupervised learning (nəzarətsiz öyrənmə) nədir?
Unsupervised learning-də data etiketsiz olur və model strukturu özü tapır. Ən çox istifadə olunan tapşırıqlar bunlardır:
- Clustering (qruplaşdırma): oxşar obyektləri qruplara bölür, məsələn alış vərdişinə görə müştəri seqmentləri. Ətraflı: Qruplaşdırma (Clustering).
- Dimensionality reduction (ölçünün azaldılması): çox sayıda dəyişəni əsas məlumatı itirmədən az sayıda dəyişənə endirir (məsələn, PCA).
- Anomaly detection (anomaliyaların aşkarlanması): normadan kənar davranışı tapır, məsələn şübhəli kart əməliyyatı.
- Association rules: “bunu alanlar bunu da alır” tipli əlaqələri aşkar edir.
Semi-supervised learning nədir?
Semi-supervised learning az sayıda etiketli və çoxlu etiketsiz nümunəni birlikdə istifadə edir. Etiketləmə bahalı və ya vaxt aparan olduğu hallarda, məsələn həkim rəyi tələb edən tibbi şəkillərdə faydalıdır. Böyük dil modellərinin (LLM) əvvəlcədən öyrədilməsində istifadə olunan self-supervised learning də bu ailəyə yaxındır: model mətndəki növbəti sözü proqnozlaşdıraraq öz etiketini özü yaradır.
Reinforcement learning (gücləndirilmiş öyrənmə) nədir?
Reinforcement learning-də agent mühitdə (environment) hərəkət edir, hər hərəkətə görə mükafat (reward) və ya cəza alır. Sınaq və səhv (trial and error) yolu ilə ümumi mükafatı ən yüksək edən strategiyanı (policy) öyrənir. Oyun oynayan sistemlər, robot idarəetməsi və chatbot-ların insan rəyinə görə təkmilləşdirilməsi (RLHF) bu yanaşmaya əsaslanır. Ətraflı: Gücləndirilmiş öyrənmə (Reinforcement Learning).
Maşın öyrənməsi alqoritmləri
Hər tapşırığın özünə uyğun alqoritmi var. Praktikada əvvəlcə sadə model (baseline) qurulur, sonra daha mürəkkəb modellərlə müqayisə edilir.
| Alqoritm | Tapşırıq | Harada istifadə olunur |
|---|---|---|
| Linear Regression | Regression | Qiymət və satış proqnozu |
| Logistic Regression | Classification | Kredit riski, müştəri itkisi (churn) |
| Decision Tree | Classification, Regression | İzahı asan qərar qaydaları |
| Random Forest | Classification, Regression | Cədvəl (tabular) data-da güclü baseline |
| Gradient Boosting (XGBoost, LightGBM, CatBoost) | Classification, Regression | Bank, sığorta, e-commerce; tabular data-da ən dəqiq nəticələrdən biri |
| Support Vector Machine (SVM) | Classification | Mətn təsnifatı, kiçik və orta data |
| K-Nearest Neighbors (KNN) | Classification, Regression | Tövsiyə sistemləri, oxşarlıq axtarışı |
| Naive Bayes | Classification | Spam filtri, mətn analizi |
| K-Means | Clustering | Müştəri seqmentasiyası |
| PCA | Dimensionality reduction | Data-nın vizuallaşdırılması və sıxılaşdırılması |
| Neural Networks | Hər biri | Şəkil, səs, mətn, generative AI |
Linear və Logistic Regression
Linear Regression giriş dəyişənləri ilə nəticə arasında düz xətti əlaqə qurur. Məsələn, mənzilin sahəsi artdıqca qiymətinin necə dəyişdiyini göstərir. Logistic Regression adında “regression” olsa da classification alqoritmidir: nəticənin bir sinfə aid olma ehtimalını (0 ilə 1 arası) hesablayır.
Decision Tree və Random Forest
Decision Tree data-nı “əgər … onda …” sualları ilə budaqlara ayırır, ona görə də nəticəsini izah etmək asandır. Tək ağac tez-tez overfitting edir. Random Forest yüzlərlə ağac qurub onların cavablarını birləşdirir və beləliklə daha sabit nəticə verir. Gradient Boosting isə ağacları ardıcıl qurur: hər yeni ağac əvvəlkilərin səhvlərini düzəltməyə çalışır.
Support Vector Machine (SVM)
SVM sinifləri bir-birindən ən geniş məsafə (margin) ilə ayıran sərhəd xəttini və ya müstəvini (hyperplane) axtarır. Kernel funksiyaları vasitəsilə xətti olmayan sərhədləri də tapa bilir.
K-Means Clustering
K-Means data-nı əvvəlcədən seçilən K sayıda qrupa bölür. Hər nöqtəni ən yaxın mərkəzə (centroid) aid edir və mərkəzlər dəyişməyənə qədər bu addımı təkrarlayır.
Neural Networks (neyron şəbəkələr)
Neyron şəbəkələr bir-birinə bağlı süni neyron qatlarından ibarətdir. Hər qat data-dan daha mürəkkəb əlamətlər çıxarır. Qatların sayı çox olduqda bu yanaşmaya deep learning deyilir. Şəkil üçün CNN, ardıcıl data üçün RNN və LSTM, mətn üçün isə Transformer arxitekturası geniş yayılıb. Ətraflı: Dərin öyrənmə və neyron şəbəkələri.
Modelin qiymətləndirilməsi: əsas machine learning metrikləri
Model test data-sında, yəni öyrədilmə zamanı görmədiyi nümunələrdə yoxlanılır. Hansı metrikdən istifadə olunacağı tapşırığın növündən və səhvin qiymətindən asılıdır.
Confusion Matrix
Classification metriklərinin əsası Confusion Matrix-dir. O, modelin cavablarını dörd qrupa bölür:
| Model: pozitiv | Model: neqativ | |
|---|---|---|
| Real: pozitiv | True Positive (TP) | False Negative (FN) |
| Real: neqativ | False Positive (FP) | True Negative (TN) |
Spam nümunəsində FP normal məktubun səhvən spam qovluğuna düşməsidir, FN isə spam-ın inbox-a keçməsidir.
Classification metrikləri
| Metrik | Düstur | Nə deyir | Nə vaxt vacibdir |
|---|---|---|---|
| Accuracy | (TP + TN) / (TP + TN + FP + FN) | Bütün cavabların neçə faizi düzgündür | Siniflər balanslı olduqda |
| Precision | TP / (TP + FP) | “Pozitiv” dediyi halların neçə faizi həqiqətən pozitivdir | FP bahalıdır: spam filtri, tövsiyə |
| Recall (Sensitivity) | TP / (TP + FN) | Real pozitivlərin neçə faizini tapıb | FN bahalıdır: xəstəlik diaqnozu, fraud |
| F1-score | 2 × Precision × Recall / (Precision + Recall) | Precision və Recall-un harmonik ortası | Siniflər balanssız olduqda |
| ROC-AUC | ROC əyrisi altındakı sahə (0.5–1) | Modelin sinifləri ayırma gücü, threshold-dan asılı deyil | Modelləri müqayisə edərkən |
| Log Loss | Proqnoz ehtimallarının cəzası | Model öz cavabına nə qədər düzgün əmindir | Ehtimal proqnozu lazım olduqda |
Vacib qeyd: balanssız data-da Accuracy aldadıcıdır. Əgər əməliyyatların 99%-i normal, 1%-i fraud-dırsa, hər şeyi “normal” adlandıran model 99% Accuracy göstərir, amma bir dənə də fraud tapmır. Belə hallarda Precision, Recall və F1-score-a baxılır.
Regression metrikləri
| Metrik | Nə deyir | Xüsusiyyəti |
|---|---|---|
| MAE (Mean Absolute Error) | Proqnozun real dəyərdən orta mütləq fərqi | İzahı asandır, hədəflə eyni vahiddədir |
| MSE (Mean Squared Error) | Xətaların kvadratlarının ortası | Böyük səhvləri daha çox cəzalandırır |
| RMSE (Root Mean Squared Error) | MSE-nin kvadrat kökü | Hədəflə eyni vahiddədir, böyük səhvlərə həssasdır |
| MAPE (Mean Absolute Percentage Error) | Orta faiz xətası | Biznes üçün anlaşıqdır, sıfıra yaxın dəyərlərdə qeyri-sabitdir |
| R² (Coefficient of Determination) | Model dəyişkənliyin neçə faizini izah edir | 1-ə yaxındırsa yaxşıdır |
Məsələn, mənzil qiyməti modelində MAE = 8,000 AZN o deməkdir ki, model orta hesabla real qiymətdən 8,000 manat yanılır.
Clustering metrikləri
Etiket olmadığı üçün clustering keyfiyyəti qrupların daxili sıxlığı ilə ölçülür: Silhouette Score (-1 ilə 1 arası, 1-ə yaxın daha yaxşıdır), Inertia (Elbow Method ilə optimal K seçmək üçün) və Davies-Bouldin Index (kiçik olması daha yaxşıdır).
Overfitting və underfitting
- Overfitting: model training data-nı əzbərləyir, yeni data-da isə zəif nəticə göstərir. Əlaməti: training metrikləri çox yüksək, test metrikləri aşağıdır.
- Underfitting: model çox sadədir və hətta training data-dakı qanunauyğunluğu da tutmur.
- Bias-Variance Tradeoff: sadə modellərin bias-ı, mürəkkəb modellərin variance-ı yüksək olur; məqsəd ikisi arasında balans tapmaqdır.
Overfitting-in qarşısını almaq üçün data train, validation və test hissələrinə bölünür, Cross-Validation tətbiq olunur, Regularization (L1, L2), Dropout və Early Stopping istifadə edilir, mümkünsə data artırılır.
Maşın öyrənməsi nümunələri: harada istifadə olunur?
Maşın öyrənməsi artıq gündəlik istifadə etdiyimiz xidmətlərin çoxunun arxasında dayanır.
| Sahə | Tətbiq | ML tapşırığı |
|---|---|---|
| Bank və maliyyə | Kredit skorinqi, fraud aşkarlanması, müştəri itkisinin (churn) proqnozu | Classification, anomaly detection |
| E-commerce və retail | Məhsul tövsiyələri, tələbat proqnozu, dinamik qiymət | Recommendation, regression |
| Marketing | Müştəri seqmentasiyası, RFM analizi, lead scoring | Clustering, classification |
| Səhiyyə | Rentgen və MRT şəkillərinin analizi, xəstəlik riskinin qiymətləndirilməsi | Computer vision, classification |
| Nəqliyyat | Taksi tətbiqlərində çatma vaxtı (ETA), marşrut optimallaşdırılması, özü-özünə hərəkət edən maşınlar | Regression, reinforcement learning |
| Kibertəhlükəsizlik | Phishing məktublarının və şəbəkə hücumlarının aşkarlanması | Classification, anomaly detection |
| Telekom | Şəbəkə yüklənməsinin proqnozu, abunəçi itkisinin qarşısının alınması | Time series forecasting, classification |
| Media və sosial şəbəkələr | YouTube, Netflix, Instagram lentlərinin fərdiləşdirilməsi | Recommendation |
| Dil və mətn | Maşın tərcüməsi, chatbot-lar, səsin mətnə çevrilməsi | NLP, deep learning |
| İdman | Oyunçu performansının və matç nəticələrinin analizi | Regression, classification |
Məsələn, bank kredit müraciətini qiymətləndirərkən müştərinin gəliri, kredit tarixçəsi və ödəniş intizamı kimi əlamətlər modelin girişinə verilir. Model isə krediti vaxtında qaytarmama ehtimalını hesablayır. Futbolda data-nın necə istifadə olunduğuna baxmaq üçün: Məlumatlarla futbol oyunlarının analizi.
Maşın öyrənməsi üçün alətlər və proqramlaşdırma dilləri
Maşın öyrənməsində əsas dil Python-dur: kitabxanaların əksəriyyəti və tədris materialları Python üçündür. Statistik analizdə R, data çıxarmaq üçün isə SQL da geniş istifadə olunur.
| Alət | Nə üçündür |
|---|---|
| NumPy, Pandas | Rəqəmsal hesablamalar, cədvəl data-sı ilə iş |
| Matplotlib, Seaborn | Data vizuallaşdırması |
| Scikit-learn | Klassik ML alqoritmləri, metriklər, preprocessing |
| XGBoost, LightGBM, CatBoost | Gradient Boosting modelləri |
| TensorFlow, Keras, PyTorch | Deep learning və neural network-lər |
| Hugging Face Transformers | Hazır dil və şəkil modelləri |
| Jupyter Notebook, Google Colab | Kodu addım-addım yazmaq və sınamaq |
| MLflow, Docker | Modellərin izlənməsi və işə salınması (MLOps) |
Maşın öyrənməsini necə öyrənmək olar?
Sıfırdan başlayan biri üçün aşağıdakı ardıcıllıq işləyir:
- Python əsası: dəyişənlər, dövrlər, funksiyalar, data strukturları. Başlanğıc: Sıfırdan Python öyrənmək.
- Riyaziyyat və statistika: xətti cəbr (vektor, matris), ehtimal nəzəriyyəsi, deskriptiv statistika, törəmə və gradient anlayışı. Bax: Ehtimal nəzəriyyəsi və Deskriptiv statistika.
- Data ilə iş: Pandas ilə data təmizləmə, Exploratory Data Analysis (EDA), vizuallaşdırma, SQL.
- Klassik ML: Scikit-learn ilə regression, classification, clustering; train/test bölgüsü, cross-validation və metriklər.
- Deep learning: PyTorch və ya TensorFlow ilə neural network-lər, CNN, Transformer.
- Real layihələr: Kaggle yarışları, açıq data-setlər üzərində portfolio, GitHub-da kod.
- MLOps: modeli API kimi işə salmaq, monitorinq və yenidən öyrətmə.
Strukturlu proqram və mentor dəstəyi ilə öyrənmək istəyirsinizsə, Alas Academy-nin Süni intellekt təlimi və Data analitika təlimi proqramlarına baxın.
Tez-tez verilən suallar
Maşın öyrənməsi ilə süni intellekt eyni şeydirmi?
Xeyr. Süni intellekt daha geniş anlayışdır, maşın öyrənməsi isə onun data-dan öyrənən hissəsidir. Müasir AI sistemlərinin əksəriyyəti ML üzərində qurulub.
Maşın öyrənməsi üçün riyaziyyat lazımdırmı?
Bəli, amma başlamaq üçün yüksək səviyyə şərt deyil. Xətti cəbr, ehtimal, statistika və törəmə anlayışı kifayətdir. Daha dərin bilik tədqiqat və yeni alqoritm yaratmaq üçün lazım olur.
Maşın öyrənməsini öyrənmək nə qədər vaxt aparır?
Python və statistika bilikləri olan biri müntəzəm məşğələ ilə klassik ML-in əsaslarını bir neçə aya öyrənə bilər. Deep learning və MLOps əlavə vaxt tələb edir. Əsas fərqi real layihələr yaradır.
Machine learning üçün ən yaxşı proqramlaşdırma dili hansıdır?
Python. Scikit-learn, PyTorch, TensorFlow və Pandas kimi əsas kitabxanalar Python üçündür və iş elanlarının əksəriyyəti Python tələb edir.
Supervised və unsupervised learning arasında fərq nədir?
Supervised learning etiketli data ilə doğru cavabı proqnozlaşdırmaq üçün öyrənir. Unsupervised learning isə etiketsiz data-da qrupları və gizli strukturu özü tapır.
Overfitting nədir?
Overfitting modelin training data-nı əzbərləyib yeni data-da zəif işləməsidir. Cross-validation, regularization və daha çox data ilə qarşısı alınır.
Machine learning mütəxəssisi nə iş görür?
Machine Learning Engineer biznes probleminin data ilə həll edilə bilən tapşırığa çevrilməsi, data-nın hazırlanması, modelin qurulması, qiymətləndirilməsi və işə salınması ilə məşğul olur. Yaxın peşələr Data Scientist və Data Analyst-dir. Bax: Data Science və data analitika nədir.
Nəticə
Maşın öyrənməsi kompüterlərə qaydaları data-dan öyrənməyə imkan verən və bu gün bankçılıqdan səhiyyəyə qədər hər sahədə istifadə olunan texnologiyadır. Onu anlamaq üçün dörd şey vacibdir: öyrənmə növləri (supervised, unsupervised, reinforcement), əsas alqoritmlər, düzgün metrik seçimi və overfitting-dən qaçmaq. Python və statistika ilə başlayıb kiçik layihələrlə davam etmək bu sahəyə girməyin ən praktik yoludur.